 Saram Consulting
어느 제약 회사의 품질 관리(QA) 팀이 성능 적격성평가(Performance Qualification, PQ) 테스트 실패 건을 조사하고 있습니다. 전자 배치 기록(Electronic Batch Record, EBR) 시스템의 토큰 만료 처리 PQ 프로토콜에서 오류가 발생했습니다. 클라이언트 측 모달이 캐시된 만료 JWT를 사용하여 전자서명을 제출한 것입니다. 일탈(Deviation)이 기록되고, 시정 및 예방조치(CAPA)가 수립되며, EBR 시스템 패치를 위한 변경 관리(Change Control) 절차가 개시됩니다.
6개월 후, 새로 입사한 컴퓨터 시스템 밸리데이션(CSV) 엔지니어가 다음과 같이 질문합니다. “토큰 만료 수정 조치의 현재 진행 상태는 어떻게 되며, 어떤 시스템들이 영향을 받나요?”
단일 평면(Flat) RAG 시스템에서는 이 질문이 벡터 유사도 매칭 과정에서 조각조각 파편화됩니다. 원래의 일탈 보고서나 CAPA, 또는 변경 관리 문서 중 하나가 검색될 수는 있지만, 올바른 인과적 순서에 따라 세 가지 모두가 온전히 도출되는 경우는 드뭅니다. 이러한 문서 및 레코드 간의 구조적 관계는 임베딩 기반 검색의 시야 밖에 있기 때문입니다.
하이브리드 GraphRAG(Hybrid GraphRAG)는 바로 이 문제를 해결합니다.
아키텍처: 세 개의 저장소, 세 가지 진실
핵심 설계 원칙은 세 가지 특화된 데이터베이스에 걸친 관심사의 분리(Separation of Concerns)입니다. 각 데이터베이스는 특정 유형의 진실을 증명하는 권위 있는 단일 원천(Authoritative Source) 역할을 수행합니다:
| 저장소 | 역할 | 답을 제공하는 질문 | 쿼리 패턴 |
|---|---|---|---|
| PostgreSQL 16 | 단일 기록 시스템 (System of Record) | “현재 승인된 유효 상태는 무엇인가?” | ACID 트랜잭션, tsvector 전문 검색, GROUP BY |
| Qdrant | 시맨틱 검색 (Semantic Retrieval) | “의미론적으로 유사한 콘텐츠는 무엇인가?” | Dense + sparse 하이브리드 검색 및 RRF 융합 |
| Memgraph | 지식 그래프 (Knowledge Graph) | “개체들이 서로 어떻게 연결되어 있는가?” | Cypher 멀티홉 BFS 탐색, 아토믹(Atomic) GraphRAG |
PostgreSQL은 시스템의 정본 소스(Canonical Source)입니다. Qdrant와 Memgraph는 PostgreSQL로부터 재구축되는 파생 인덱스(Derived Indexes)이며, 그 반대로 동작하는 일은 절대 없습니다. 이는 21 CFR Part 11 규정 준수 하에서 시스템의 감사 가능성(Auditability)을 보장하는 핵심 아키텍처 불변식(Architectural Invariant)입니다.
                               ┌────────────────────────────────────────────────────────┐
                               │                    USER QUERY / AGENT                  │
                               └──────────────────────────┬─────────────────────────────┘
                                                          │
                                             ┌────────────▼────────────┐
                                             │    Intent Classifier    │
                                             │    & Query Rewriter     │
                                             └──────┬──────┬─────┬─────┘
                                                    │      │     │
                 ┌──────────────────────────────────┘      │     └──────────────────────────────────┐
                 │ (Semantic Search)                       │ (Multi-Hop / Traceability)             │ (Relational / Audit)
                 ▼                                         ▼                                        ▼
   ┌───────────────────────────┐             ┌───────────────────────────┐            ┌───────────────────────────┐
   │          QDRANT           │             │         MEMGRAPH          │            │        POSTGRESQL         │
   │  - Dense + Sparse vectors │             │  - In-Memory C++ Graph    │            │  - System of Record       │
   │  - Prefetch + RRF Fusion  │             │  - Atomic GraphRAG query  │            │  - ACID Audit Logs        │
   │  - Tenant / GxP Filtering │             │  - Traceability BFS / WSP │            │  - tsvector Full-Text     │
   │  - Sub-5ms ANN Latency    │             │  - MAGE Community Clusters│            │  - Relational Aggregates  │
   └─────────────┬─────────────┘             └─────────────┬─────────────┘            └─────────────┬─────────────┘
                 │                                         │                                        │
                 └──────────────────┬──────────────────────┘                                        │
                                    │                                                               │
                                    ▼                                                               │
                     ┌─────────────────────────────┐                                                │
                     │    Hybrid Fusion & Rerank   │                                                │
                     │    (RRF + Cross-Encoder)    │                                                │
                     └──────────────┬──────────────┘                                                │
                                    │                                                               │
                                    ▼                                                               │
                     ┌─────────────────────────────┐                                                │
                     │        EvidenceGate         │◄───────────────────────────────────────────────┘
                     │ (Zero-Trust Live ACL &      │
                     │  Supersession Revalidation) │
                     └──────────────┬──────────────┘
                                    │
                                    ▼
                     ┌─────────────────────────────┐
                     │   Context Assembly & LLM    │
                     │  (Grounded Citations + Path)│
                     └─────────────────────────────┘
인텐트 라우터: 모든 쿼리가 동일하지는 않다
검색(Retrieval)이 시작되기 전에 시스템은 쿼리의 의도(Intent)를 먼저 분류합니다. 이 분류 결과에 따라 벡터 검색과 그래프 순회(Traversal)의 가중치를 어떻게 배분할지가 결정됩니다:
| 의도 (Intent) | 트리거 키워드 | 주 저장소 | 벡터 가중치 | 그래프 가중치 |
|---|---|---|---|---|
| TRACEABILITY_AUDIT | “traceability”, “URS-”, “test failed”, “V-model” | Memgraph + Postgres | 0.3 | 0.7 |
| IMPACT_ANALYSIS | “deviation”, “CAPA”, “root cause”, “ripple effect” | Memgraph | 0.4 | 0.6 |
| GLOBAL_GOVERNANCE | “all systems”, “GAMP category”, “overview” | Postgres + Memgraph | 0.5 | 0.5 |
| SEMANTIC_SEARCH | (기본값) | Qdrant + Memgraph | 0.7 | 0.3 |
*“URS-EBR-001의 전체 추적성 체인을 보여줘”*와 같은 쿼리는 Memgraph로 집중 라우팅됩니다(그래프 가중치 70%). 반면 *“데이터 완전성(Data Integrity)을 위한 ALCOA+의 요구사항은 무엇인가?”*와 같은 쿼리는 Qdrant 시맨틱 검색으로 라우팅됩니다(벡터 가중치 70%).
이는 단순한 양자택일식 스위칭이 아닙니다. 상호 순위 융합(Reciprocal Rank Fusion, RRF) 점수 산정 공식에서 가중치를 동적으로 조정하는 메커니즘입니다.
Qdrant: 밀집(Dense) + 희소(Sparse) 하이브리드 검색
Qdrant 컬렉션은 밀집 임베딩(FastEmbed를 통한 all-MiniLM-L6-v2 기반 384차원 벡터)과 희소 토큰 가중치 벡터(BM25 스타일의 용어 빈도 해싱)를 모두 저장합니다. 하이브리드 검색은 상호 순위 융합(RRF)으로 결합되는 병렬 프리페치(Prefetch) 쿼리로 실행됩니다:
# Parallel prefetch: dense + sparse
prefetch_queries = [
    models.Prefetch(query=dense_vector, using="dense", filter=query_filter, limit=limit * 3),
    models.Prefetch(
        query=models.SparseVector(indices=sparse_indices, values=sparse_values),
        using="sparse", filter=query_filter, limit=limit * 3
    )
]

# RRF fusion
search_result = client.query_points(
    collection_name=collection_name,
    prefetch=prefetch_queries,
    query=models.FusionQuery(fusion=models.Fusion.RRF),
    limit=limit
)
페이로드 사전 필터링(Payload pre-filtering)은 효력이 상실된 구버전 문서(is_superseded == False)와 특정 시스템 관련 쿼리(system_name == 'EBR')를 검색 후 단계가 아닌 인덱스 레벨에서 즉각 제외하도록 보장합니다. 이는 GxP 환경에서 극히 중요합니다. 효력이 만료된 구버전 표준작업지침서(SOP)가 현재 유효한 SOP와 함께 검색 결과로 노출된 상태에서 LLM이 둘을 스스로 구분해 주기를 기대해서는 안 되기 때문입니다.
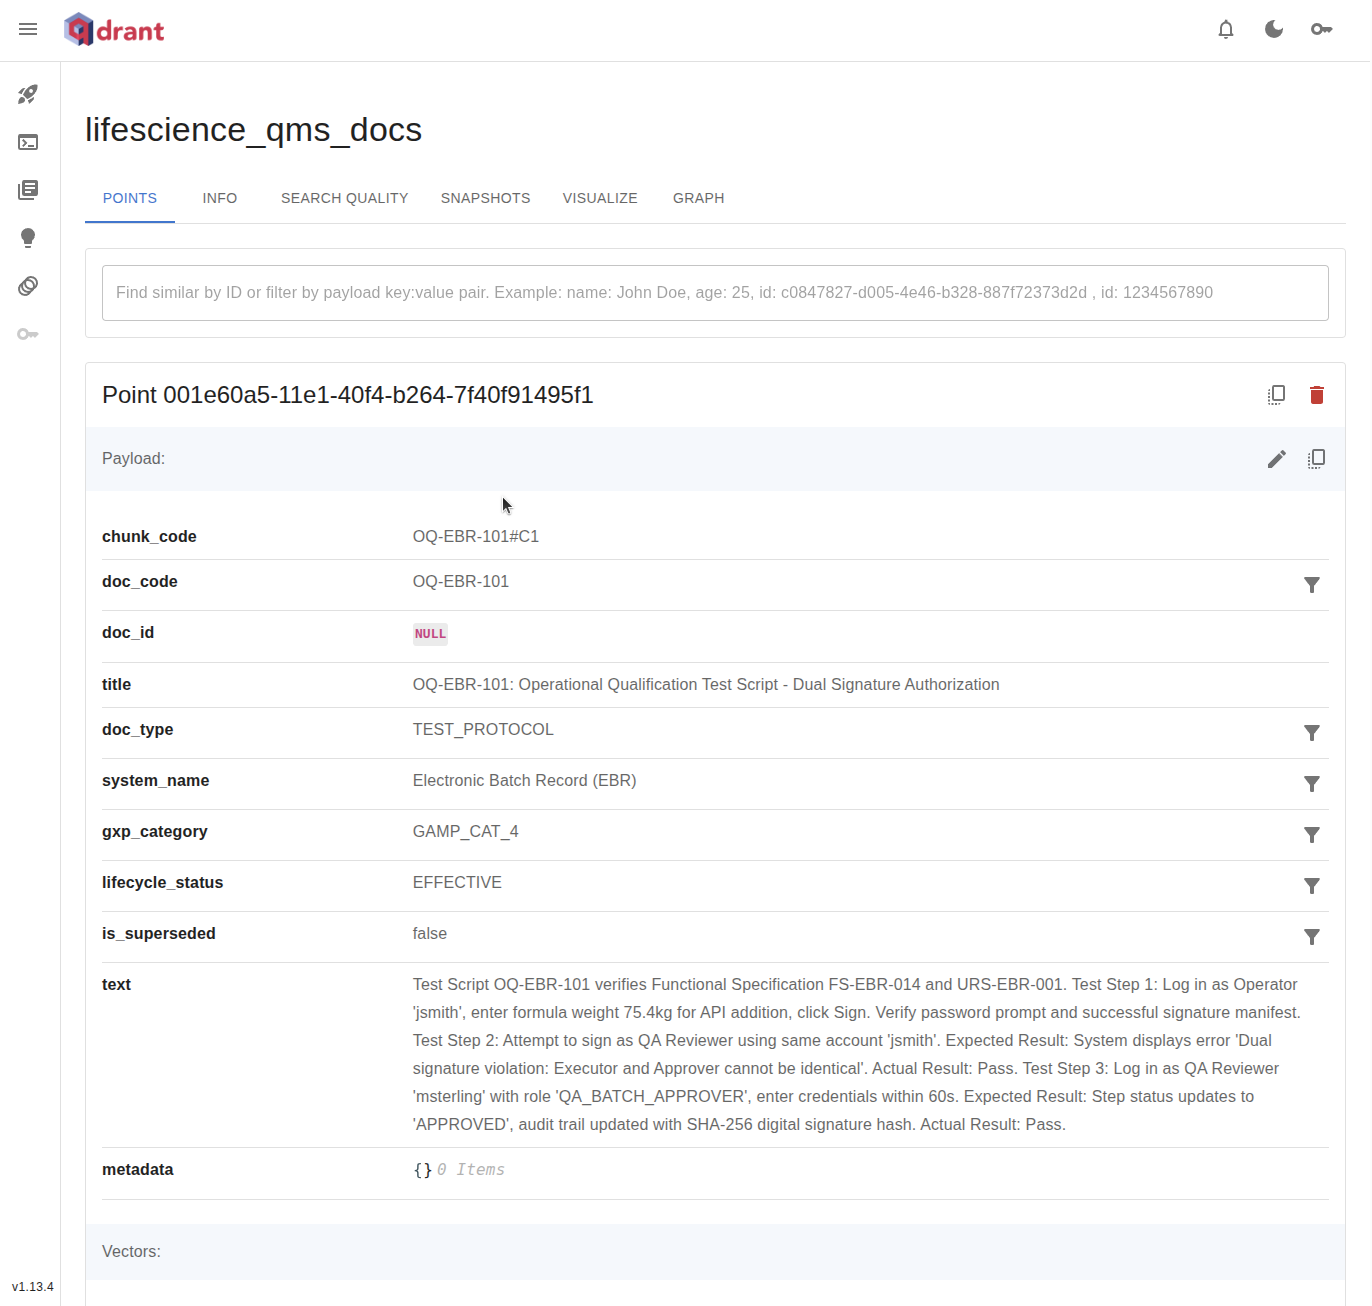
Qdrant 대시보드에서는 doc_code, doc_type, system_name, gxp_category, lifecycle_status, is_superseded에 대해 구성된 페이로드 인덱스와 함께 컬렉션을 확인할 수 있습니다:
Memgraph: 멀티홉(Multi-Hop) 지식 그래프
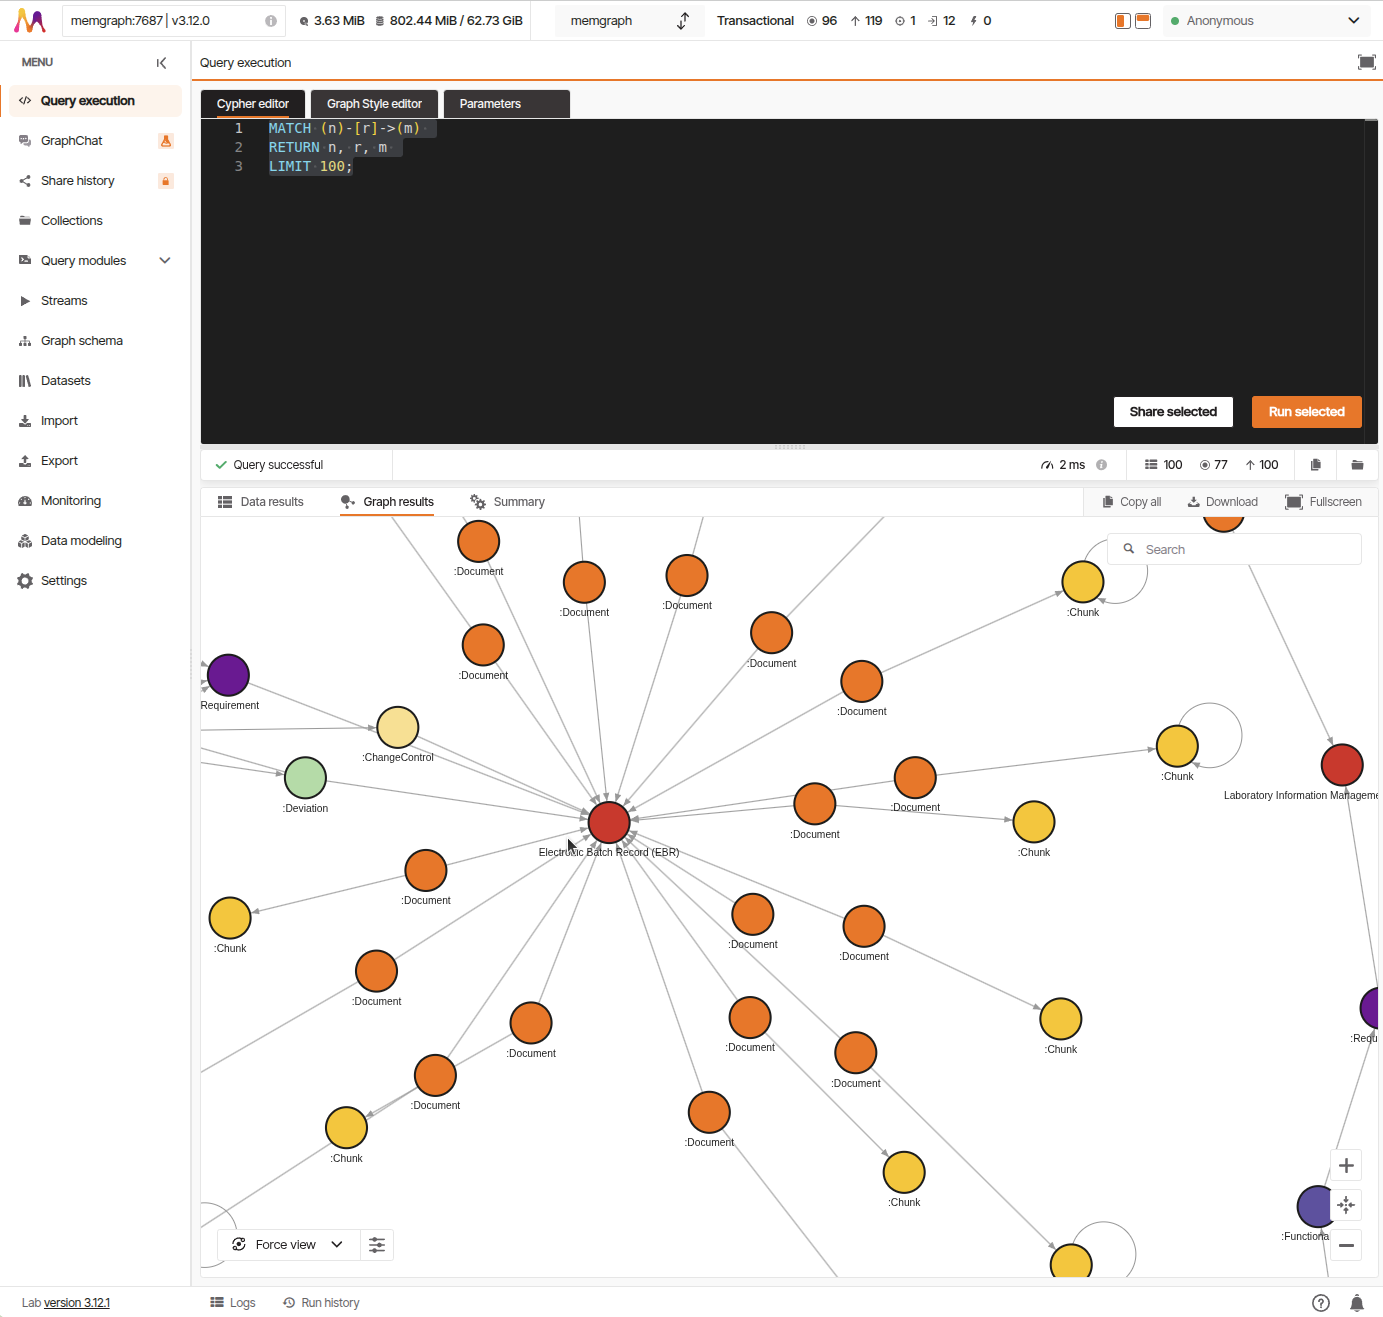
Memgraph는 벡터 검색으로는 포착할 수 없는 구조적 관계를 저장합니다. 그래프 모델은 GAMP 5 V-모델(V-Model) 수명주기를 인코딩합니다:
(Requirement)-[:IMPLEMENTS_URS]->(FunctionalSpec)
(FunctionalSpec)-[:SPECIFIES_FS]->(DesignSpec)
(DesignSpec)-[:VERIFIES_DS]->(TestScript)
(TestScript)-[:TRIGGERED_DEVIATION]->(Deviation)
(Deviation)-[:RESOLVED_BY_CAPA]->(CAPA)
(CAPA)-[:REQUIRES_CHANGE_CONTROL]->(ChangeControl)
(ChangeControl)-[:MODIFIES_SYSTEM]->(System)
멀티홉 추적성 쿼리는 단 하나의 Cypher 구문으로 이 연결 체인을 순회합니다:
MATCH (u:Requirement)
WHERE toLower(u.code) CONTAINS toLower($keyword)
OPTIONAL MATCH (f:FunctionalSpec)-[:IMPLEMENTS_URS]->(u)
OPTIONAL MATCH (ds:DesignSpec)-[:SPECIFIES_FS]->(f)
OPTIONAL MATCH (t:TestScript)-[:VERIFIES_DS]->(ds)
OPTIONAL MATCH (t)-[:TRIGGERED_DEVIATION]->(dev:Deviation)
OPTIONAL MATCH (dev)-[:RESOLVED_BY_CAPA]->(capa:CAPA)
RETURN u.code, f.code, ds.code, t.code, t.status,
       dev.code, dev.severity, capa.code
또한 Memgraph는 **아토믹 GraphRAG(Atomic GraphRAG)**를 지원합니다. 이는 vector_search.search()를 사용하여 Cypher 쿼리 내부에서 직접 벡터 검색 진입점을 실행하는 방식입니다. 이를 통해 시스템은 의미론적으로 유사한 청크를 찾은 즉시, 인접한 그래프 이웃 노드 영역으로 곧바로 확장할 수 있습니다:
CALL vector_search.search("chunk_vec", $limit, $query_embedding)
YIELD node AS start_chunk, similarity
OPTIONAL MATCH path = (start_chunk)-[*1..2]-(connected)
RETURN start_chunk.code, similarity,
       [n IN nodes(path) | {label: labels(n)[0], code: n.code}] AS context_entities
Memgraph Lab 시각화 화면은 타입화된 관계로 연결된 요구사항 노드, 테스트 스크립트, 일탈, CAPA, 변경 관리를 아우르는 전체 지식 그래프를 보여줍니다:
EvidenceGate: 제로 트러스트(Zero-Trust) 검색 검증
규제 대상 환경에서 시스템의 안전성을 담보하는 핵심 컴포넌트가 바로 EvidenceGate입니다. Qdrant나 Memgraph에서 검색된 모든 후보 청크(Candidate chunk)는 LLM 프롬프트로 조합되기 직전에 가로채어져(intercepted), 라이브 PostgreSQL의 최신 상태와 대조 검증을 거칩니다:
Retrieved Candidates (Qdrant & Memgraph)
                  │
                  ▼
       ┌────────────────────┐
       │    EvidenceGate    │ ─── Queries live PostgreSQL System of Record
       └──────────┬─────────┘
                  │
       ┌──────────┴──────────┐
       ▼                     ▼
[APPROVED & EFFECTIVE]    [SUPERSEDED / OBSOLETE]
       │                     │
       ▼                     ▼
Prompt Assembly        Rejected & Logged
(Citations injected)   (Audit reason recorded)
EvidenceGate는 PostgreSQL을 상대로 다음 세 가지 조건을 검증합니다:
- 존재성(Existence) — 청크 코드가 표준
documents+chunks테이블에 실제로 존재해야 합니다. - 수명주기 상태(Lifecycle status) — 상태가 반드시
EFFECTIVE(유효) 또는APPROVED(승인됨)여야 합니다 (DRAFT,OBSOLETE,QUARANTINED상태 제외). - 효력 만료 여부(Supersession) —
is_superseded값이 반드시FALSE여야 합니다.
만약 청크가 단 하나의 검증이라도 통과하지 못하면 해당 사유 코드(예: DOCUMENT_IS_SUPERSEDED, INVALID_LIFECYCLE_STATUS)와 함께 즉각 반려되며, 이 내역은 감사 추적(Audit trail)에 기록됩니다. LLM은 해당 청크를 결코 보지 못합니다.
이 메커니즘은 **오래된 인덱스 문제(Stale index problem)**를 해결합니다. 예를 들어 특정 일탈 발생 후 특정 SOP가 품질 보증(QA) 보류 상태로 전환되었더라도, Qdrant의 벡터 임베딩은 여전히 이를 최상위 결과로 반환할 수 있습니다. EvidenceGate는 쿼리 실행 시점에 라이브 PostgreSQL의 최신 상태를 실시간 확인하여 이러한 위험을 원천 차단합니다.
5단계 폐쇄 루프(Closed-Loop) 워크플로우
Pydantic AI 에이전트는 지식의 선순환 루프를 완성하는 5단계 워크플로우를 오케스트레이션합니다:
                        ┌───────────────────────────────┐
                        │        1. Query Intake        │
                        └───────────────┬───────────────┘
                                        │
                                        ▼
                        ┌───────────────────────────────┐
                   ┌───►│   2. Vector/Graph Retrieval   │
                   │    └───────────────┬───────────────┘
                   │                    │
                   │                    ▼
Knowledge          │    ┌───────────────────────────────┐
Feedback           │    │  3. Agent Response & Feedback │
Loop               │    │       (Pydantic AI)           │
                   │    └───────────────┬───────────────┘
                   │                    │
                   │                    ▼
                   │    ┌───────────────────────────────┐
                   │    │ 4. Ticket Escalation/Resolut. │
                   │    └───────────────┬───────────────┘
                   │                    │
                   │                    ▼
                   │    ┌───────────────────────────────┐
                   └────┤ 5. Auto-Ingestion & Indexing  │
                        └───────────────────────────────┘
1단계 (쿼리 접수 - Query Intake): 사용자 쿼리, 사용자 역할(Role), 쿼리 유형, 휴먼 인 더 루프(HITL) 토글 활성화 여부를 접수합니다. 21 CFR Part 11 출처 추적성(Provenance)을 위해 고유 추적 ID(TICK-XXXXXX)를 발급합니다.
2단계 (검색 - Retrieval): Qdrant(Dense + Sparse 하이브리드), Memgraph(멀티홉 그래프 순회), PostgreSQL(EvidenceGate 검증)에 걸쳐 병렬 검색을 실행합니다.
3단계 (에이전트 응답 - Agent Response): OpenAI 호환 API를 통해 DeepSeek-v4-flash 모델을 사용하는 Pydantic AI 에이전트가 신뢰도 점수, GxP 리스크 등급, 검증된 인용 출처, 그래프 순회 경로를 포함하는 구조화된 HelpdeskResolution 객체를 종합 생성합니다.
4단계 (에스컬레이션 - Escalation): 리스크 수준에 따라 처리를 라우팅합니다. 치명적(Critical) 일탈 건은 QA 리드에게 에스컬레이션됩니다. 신뢰도가 높은 일반 문의는 자동으로 해결(Auto-resolve)됩니다. 휴먼 인 더 루프(Human-in-the-loop) 모드가 활성화된 경우 전자서명 승인을 위해 강제로 PENDING_HUMAN_IN_LOOP 상태로 전환됩니다.
5단계 (지식 피드백 루프 - Knowledge Feedback Loop): 자가 학습(Self-learning)을 구현하는 핵심 단계입니다. 도출된 해결 결과는 PostgreSQL에 새로운 정본 문서로 자동 수집(Auto-ingestion)되고, Qdrant에 벡터 임베딩으로 투영되며, Memgraph에 엔티티 관계로 연결됩니다. 이후 유사한 주제의 쿼리가 인입되면 시스템은 이전에 학습된 경험을 즉시 검색해 활용합니다. 사이클이 반복될 때마다 해결 정확도는 회당 약 1.8%씩 향상됩니다.
Pydantic AI 에이전트의 구조화된 출력(Structured output)은 강력한 타입 안전성을 강제합니다:
class HelpdeskResolution(BaseModel):
    resolution_summary: str
    confidence_score: float = Field(ge=0.0, le=1.0)
    gxp_risk_level: Literal["LOW", "MEDIUM", "HIGH", "CRITICAL"]
    citations: List[CitationItem]
    graph_paths: List[str]
    action_verdict: Literal["AUTO_RESOLVED", "ESCALATED_TO_QA", "PENDING_HUMAN_IN_LOOP"]
    knowledge_feedback_generated: bool
    feedback_details: Optional[KnowledgeUpdatePayload]
시드 데이터: 실제 제약 GxP 시나리오
이 시스템은 실제 제약 품질 관리 환경을 그대로 반영하는 시드 데이터셋을 기본 제공합니다:
규제 거버넌스(Regulatory Governance): FDA 21 CFR Part 11 (전자 기록 및 전자 서명), EU Annex 11 (컴퓨터화 시스템), ISPE GAMP 5 (V-모델 수명주기), ALCOA+ 데이터 완전성 원칙.
대상 시스템(Target Systems): 전자 배치 기록(EBR), 크로마토그래피 데이터 시스템(CDS — Empower), 실험실 정보관리 시스템(LIMS), 제조 실행 시스템(MES — DeltaV), Veeva Vault QMS.
추적성 체인(Traceability Chains):
URS-EBR-001→FS-EBR-014→DS-EBR-089→OQ-EBR-101(합격/PASSED)URS-EBR-001→FS-EBR-014→DS-EBR-089→PQ-EBR-202(불합격/FAILED) →DEV-2026-091→CAPA-2026-022→CC-2026-068
품질 이벤트(Quality Events): EBR 전자서명의 토큰 만료 경쟁 상태(Race condition)와 동시 접속 환경에서의 크로마토그래피 감사 추적 누락 이슈를 다루는 2개의 완전한 일탈-CAPA-변경 관리 체인.
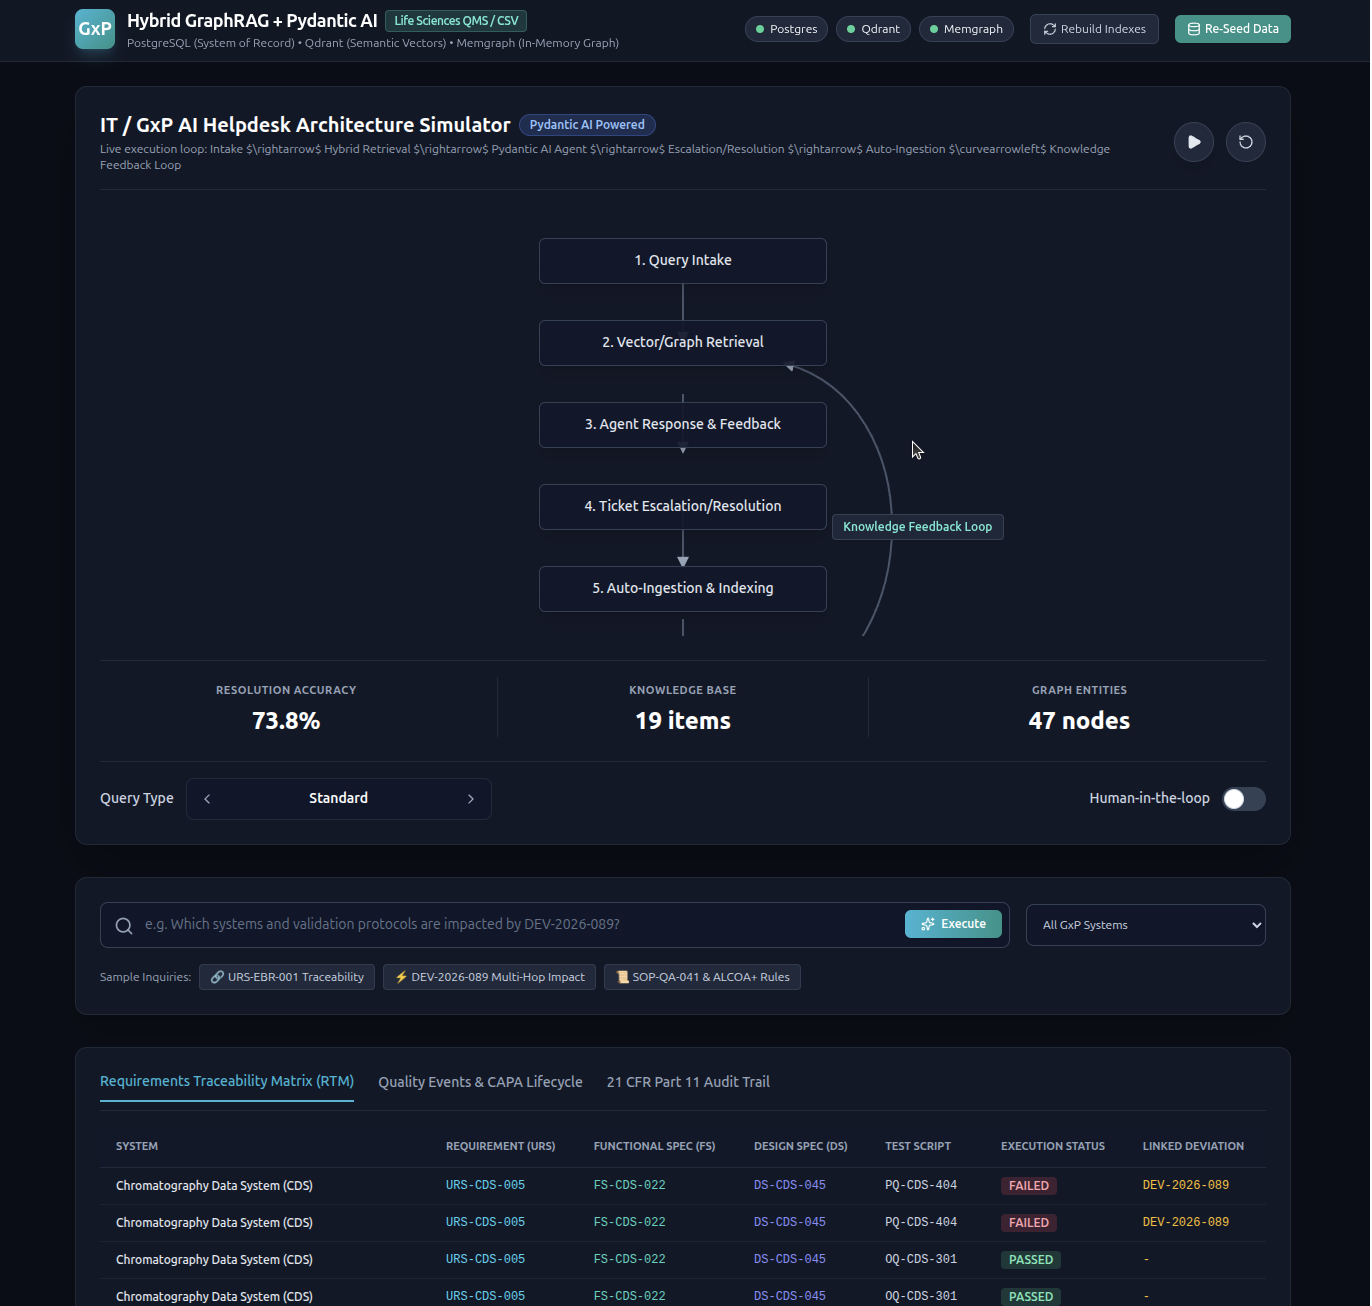
웹 UI
이 시스템은 localhost:8090에서 동작하는 인터랙티브 웹 UI를 제공합니다. 5단계 폐쇄 루프 워크플로우를 애니메이션으로 시뮬레이션하며, 쿼리 유형 캐러셀(표준 문의, 멀티홉 추적성, 일탈 영향 분석, 복합 인시던트), 휴먼 인 더 루프 토글 스위치, 실시간 지표 바(Metrics bar), 지식 그래프 노드와 엣지를 탐색할 수 있는 Cytoscape.js 기반 서브그래프 시각화 도구를 포함합니다:
Docker Compose 배포
전체 기술 스택은 Docker Compose를 통해 5개의 컨테이너로 구동됩니다:

| 컨테이너 | 이미지 | 포트 | 역할 |
|---|---|---|---|
hybrid-rag-postgres |
pgvector/pgvector:pg16 | 5434 | 단일 기록 시스템 (System of Record) |
hybrid-rag-qdrant |
qdrant/qdrant:v1.13.4 | 6335 | 벡터 검색 |
hybrid-rag-memgraph |
memgraph/memgraph-mage:latest | 7688 | 지식 그래프 |
hybrid-rag-memgraph-lab |
memgraph/lab:latest | 3006 | 그래프 시각화 |
hybrid-rag-api |
커스텀 (Python 3.12) | 8090 | FastAPI + 웹 UI |
단 한 줄의 명령어로 실행할 수 있습니다:
./run.sh
# 또는 수동 실행:
docker compose up -d --build
docker compose exec api python -m src.seed.seed_all
LLM 폴백 체인 (Fallback Chain)
종합 생성기(Synthesizer)는 LLM 생성을 위한 4단계 계층형 폴백(Fallback) 구조를 갖추고 있습니다:
- DeepSeek-v4-flash (기본) — OpenAI 호환 API 연동
- OpenAI GPT-4o-mini — DeepSeek API 키 부재 시 폴백
- Ollama 로컬 모델 — 망 분리(Air-gapped) 폐쇄망 환경 지원
- 내장 규제 룰 엔진 — 외부 의존성 0%, 검색된 검증 증거만을 활용한 의도별 맞춤 합성
여기서 네 번째 계층이 매우 중요합니다. 이 시스템은 어떠한 외부 LLM 없이도 완전히 작동할 수 있습니다. 룰 엔진은 검증된 텍스트 청크와 그래프 경로를 의도별 템플릿에 맞춰 포맷팅함으로써 구조화된 규제 평가서를 생성합니다. 이는 LLM 장애 발생 시에도 시스템의 연속적인 운영을 가능케 하는 결정론적 폴백(Deterministic fallback) 메커니즘입니다.
결론: 요약 및 제언
비정형 문서에 대한 단순 질의응답이라면 단일 평면(Flat) RAG로도 충분합니다. 그러나 요구사항(URS)을 기능 규격서(FS)와 설계 규격서(DS)로 추적하고, 이를 테스트 프로토콜, 발생한 일탈(Deviation), 수립된 CAPA, 그리고 변경 관리(Change Control)로 연계하면서 해당 체인의 모든 노드가 현재 유효하게 승인된 상태인지 검증해야 하는 순간, 기존 Flat RAG는 완전히 무너집니다.
하이브리드 GraphRAG는 세 데이터베이스 각각에 단 하나의 명확한 책임을 부여하여 이 문제를 해결합니다. PostgreSQL은 진실의 정본을 관리하고, Qdrant는 의미론적 유사도를 찾아내며, Memgraph는 개체 간의 유기적 관계를 매핑합니다. 그리고 EvidenceGate를 통해 LLM이 오직 검증되고 승인된 최신의 증거만을 열람하도록 통제합니다. 여기에 지식 피드백 루프가 더해져, 시스템은 쿼리를 해결할 때마다 스스로 더 똑똑해집니다.
전체 코드베이스는 MIT 라이선스 오픈소스로 공개되어 있습니다. 시드 데이터는 실제 제약 품질 시나리오를 충실히 구현하고 있으며, Docker Compose 스택은 8GB RAM 사양의 PC에서도 손쉽게 구동됩니다.
환각(Hallucination)으로 인한 잘못된 인용 하나가 곧바로 FDA 483 지적사항(Observation)으로 이어질 수 있는 엄격한 규제 환경에서 AI 시스템을 구축하고 있다면, 본 아키텍처 패턴은 반드시 연구해 보아야 할 최적의 청사진입니다.
소스 코드: GitHub hybrid-graphrag • 아키텍처: PostgreSQL 16 + Qdrant v1.13.4 + Memgraph MAGE + Pydantic AI • LLM: DeepSeek-v4-flash